自動アノテーション
Pro 版は正式にアーカイブされました
Pro 版は正式にアーカイブされ、独立した製品としての更新を終了しました。
現在の自動アノテーション
新版の Std 標準版で 画像アノテーション → モデル自動アノテーション を開き、必要な推論コンポーネントをインストールしてモデルを選択します。Pro 版や Trainer のインストールは不要です。
アノテーションと自動アノテーションの説明 · 推論コンポーネントを入手
推論コンポーネントは既存モデルの推論用であり、モデル学習環境を含みません。以下の Pro 版の学習手順と旧画面の説明は履歴として保存しています。
Pro 版の旧機能(アーカイブ)
1. 主な機能
通常の物体検出と OBB 回転矩形検出、YOLO26(n / s / m / l / x)に対応します。元データセットのフォルダーを指定し、学習から自動アノテーションまで実行します。
2. 学習手順
- 画像と JSON のデータセットフォルダーを指定。
- 重み・ログ・グラフの保存先を指定。
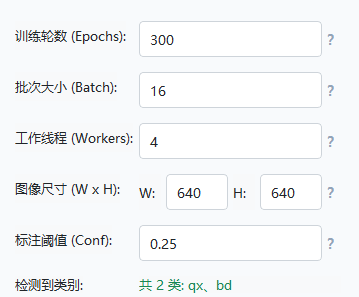
- エポック数とバッチサイズを設定。
- 画像サイズは既定の 640 × 640 を目安にし、変更する場合も 32 の倍数にします。
- ハードウェアに応じて詳細設定を調整し、学習を開始。
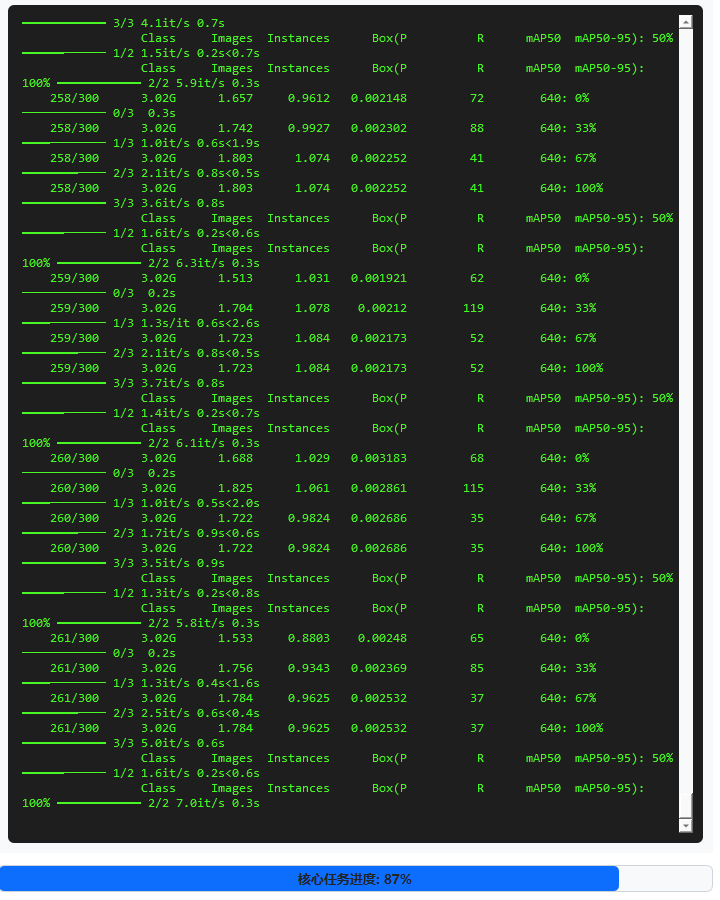
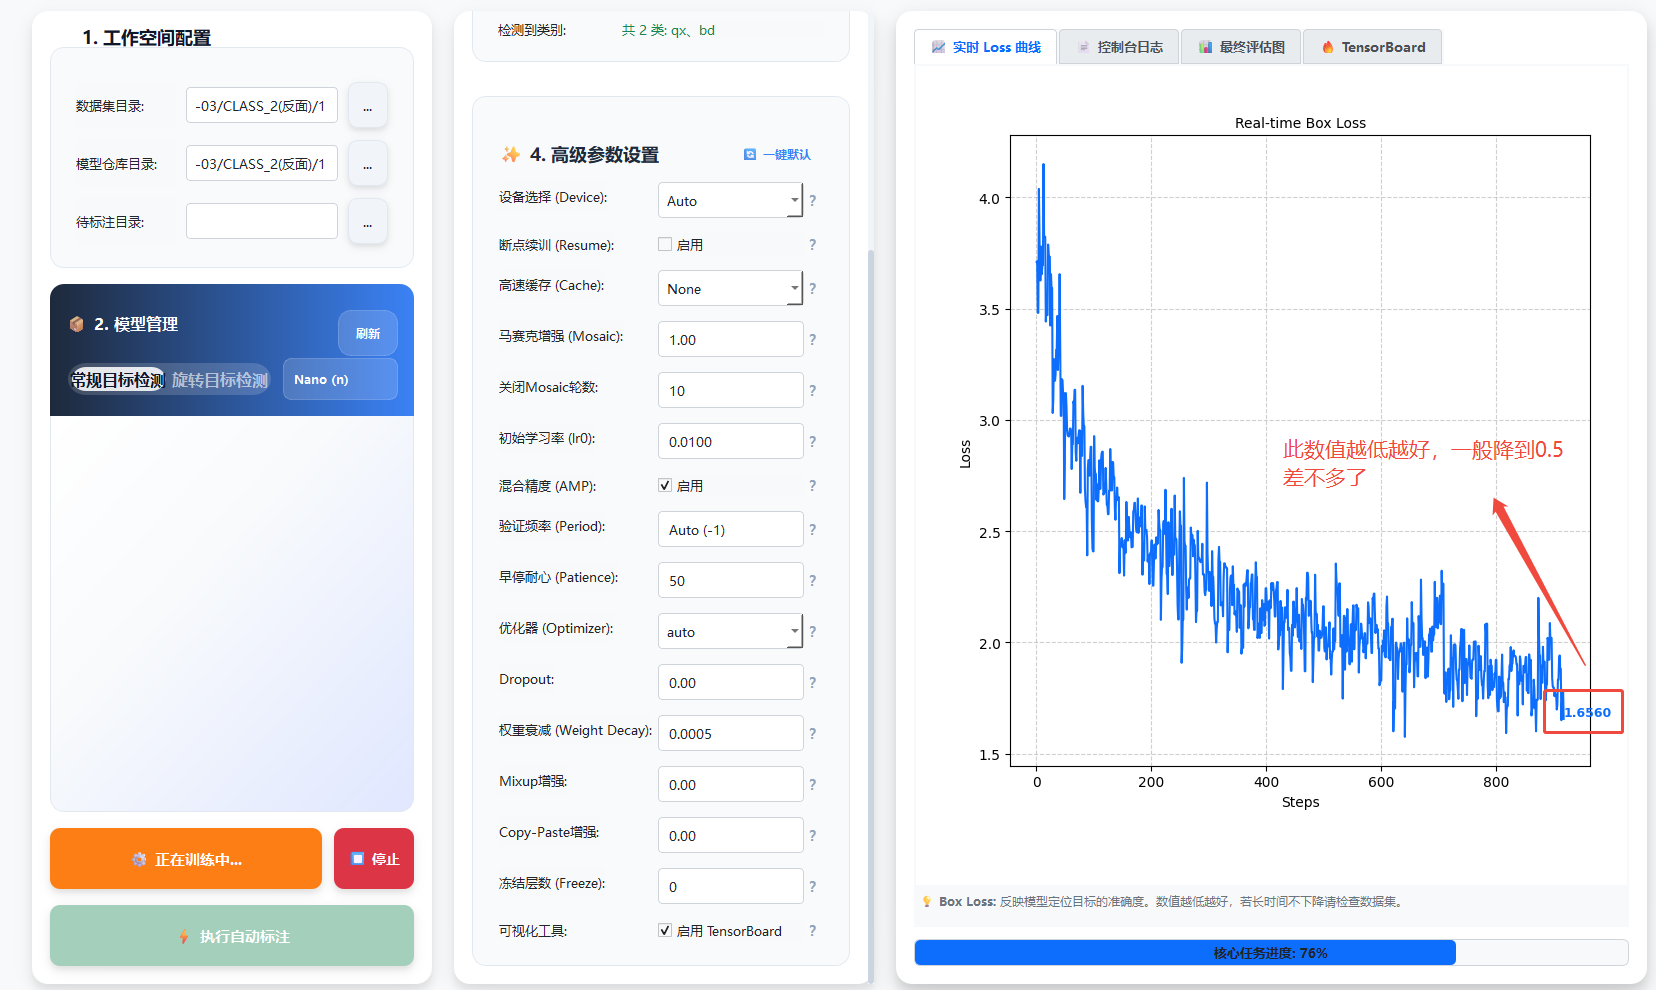
Box Loss は位置推定誤差の指標で、小さいほど良好です。元の説明では約 0.5 が目安とされていますが、値はデータと設定に依存するため、検証指標と合わせて確認してください。
3. 基本設定
| パラメーター | 内容 |
|---|---|
| Epochs | データ全体を学習する回数 |
| Batch | 一度に処理する画像数。GPU メモリが少ない場合は減らす。-1 は自動 |
| Workers | データ読み込みプロセス数。Windows では 0~4 を推奨 |
| W x H | 入力サイズ。既定は 640 × 640、32 の倍数 |
| Conf | 自動アノテーションで採用する信頼度の下限 |
4. 詳細設定
不明な項目は既定値を使用してください。
| 項目 | 内容 |
|---|---|
| Device | Auto: 自動、0: 最初の GPU、cpu: CPU |
| Resume | last.pt を検索して学習を再開 |
| Cache | RAM またはディスクにキャッシュ。メモリ不足時は無効 |
| Mosaic | 複数画像の合成確率 0.0~1.0 |
| Close Mosaic | 最後の N エポックで Mosaic を無効化 |
| lr0 | 初期学習率。通常 0.01 |
| AMP | 混合精度で GPU メモリと処理時間を削減 |
| Period | 重み保存・検証の間隔。-1 は自動 |
| Patience | 指標が改善しない場合に早期終了。0 は無効 |
| Optimizer | auto、SGD、AdamW など |
| Dropout | 過学習を抑える割合 0.0~1.0 |
| Weight Decay | L2 正則化係数 |
| Mixup | 画像とラベルを混合する確率 0.0~1.0 |
| Copy-Paste | 物体を他の画像に貼り付ける拡張 |
| Freeze | 先頭 N 層の重みを固定 |
| TB | TensorBoard に Loss と指標を記録 |
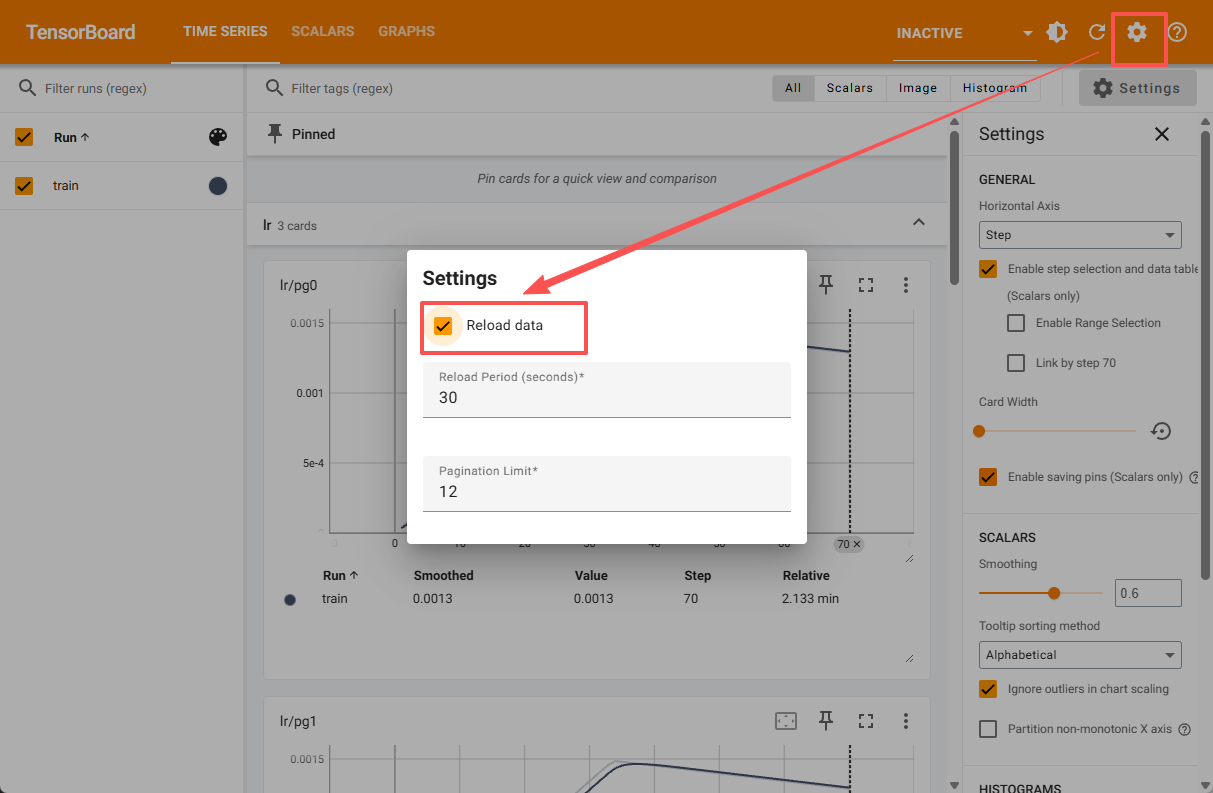
TensorBoard の「Reload data」を有効にすると、既定では 30 秒間隔で更新します。
5. 自動アノテーション
best.pt などの重みを選び、Conf を設定して実行します。0.3~0.5 を目安に対象に合わせて調整してください。画像ごとの JSON を生成した後は、「画像ラベル」で目視確認します。
6. 評価結果
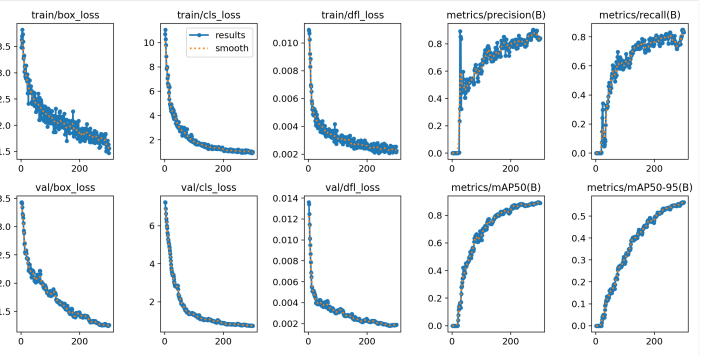
学習後に生成される評価グラフを確認してください。
実行時の注意
- 学習中にコンソールを閉じると処理が中断されます。
- OBB の JSON 定義を確認してください。
Length1/Length2は半幅・半高さです。