12. Auto Labeling
Edizione Pro ufficialmente archiviata
L’Edizione Pro è ufficialmente archiviata e non riceverà ulteriori aggiornamenti come prodotto separato.
Procedura attuale di annotazione automatica
Nella nuova Edizione Standard apri Annotazione immagini → Annotazione automatica, installa il componente di inferenza richiesto e seleziona il modello. Non occorrono né l’Edizione Pro né Trainer.
Guida all’annotazione e all’annotazione automatica · Ottieni i componenti di inferenza
I componenti di inferenza eseguono modelli già addestrati e non includono un ambiente di training. Le istruzioni Pro e le vecchie interfacce seguenti sono conservate solo come documentazione storica.
Funzionalità Pro storiche (archiviate)
1. Funzionalità Principali
- Supporto multi-architettura: supporta completamente la horizontal object detection standard e la OBB rotated box detection.
- Supporto full-series: l'algoritmo di addestramento è profondamente adattato alla serie YOLO26 (n, s, m, l, x).
- Importazione zero-configurazione: analizza direttamente la directory del dataset grezzo, senza necessità di packaging aggiuntivo.
2. Passi del Training del Modello
Passo 1: Configurazione dei Percorsi
- Directory del dataset: clicca sul pulsante [...] e puntalo alla cartella contenente le immagini e le loro corrispondenti label JSON.
- Directory del repository del modello: scegli il percorso in cui verranno memorizzati i risultati del training (pesi, log, grafici).
Passo 2: Regolazione dei Parametri
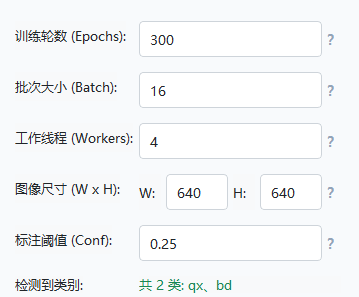
- Imposta gli epochs e la batch size nel pannello Basic Parameters.
- [Importante]: si consiglia di mantenere l'image size (W x H) al valore predefinito 640 * 640. Se hai bisogno di modificarla, il valore deve essere un multiplo di 32.
- Apporta modifiche in base al tuo hardware nel pannello Advanced Parameters.
Passo 3: Avvio e Monitoraggio
- Clicca su [Start Training] e osserva i log in tempo reale e la barra di avanzamento nella console integrata.
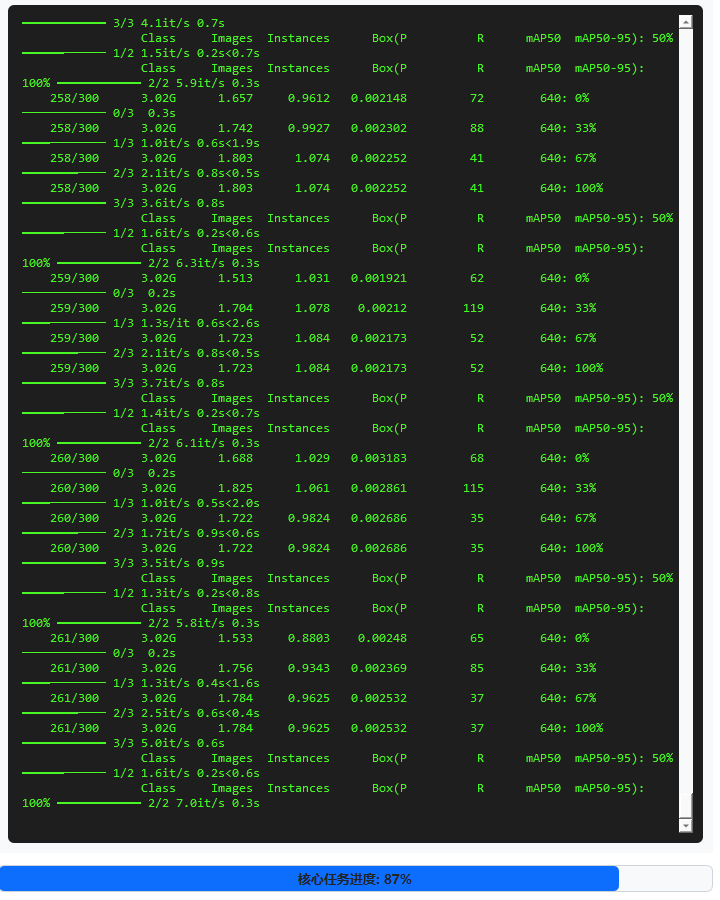
Box Loss
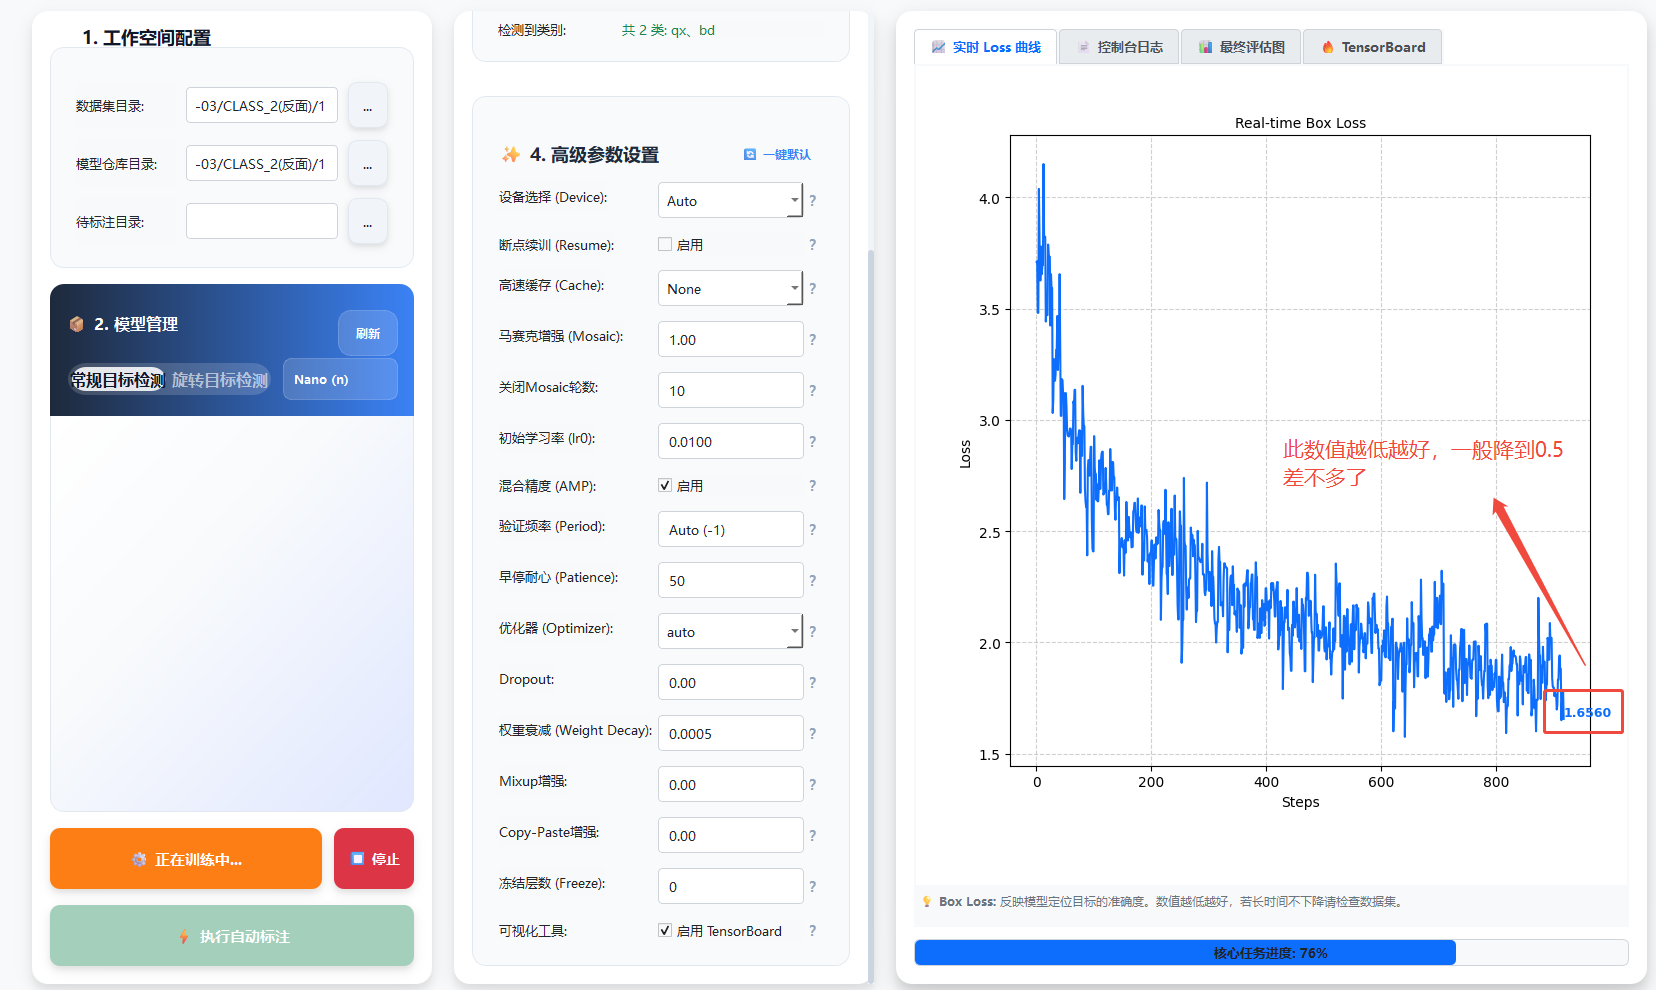
Più basso è il valore della loss, meglio è; in generale scende intorno a 0.5.
3. Parametri di Training di Base
| Parametro | Codice | Descrizione |
|---|---|---|
| Epochs | Epochs | Determina quanti passaggi completi il modello esegue sui dati. Più grande è il valore, più lungo sarà il training. |
| Batch size | Batch | Il numero di immagini fornite al modello contemporaneamente. Abbassalo se la memoria GPU è limitata. -1 significa automatico. |
| Workers | Workers | Il numero di processi di caricamento dati. Su Windows, si consiglia 0 ~ 4 per evitare errori. |
| Image size | W x H | 640 * 640 per impostazione predefinita. La dimensione a cui le immagini di input vengono scalate; deve essere un multiplo di 32. |
| Confidence threshold | Conf | La soglia di confidenza per l'auto labeling; i box al di sotto di questo valore vengono filtrati. |
4. Parametri Avanzati
Raccomandazione sulla Configurazione
Se non hai familiarità con i seguenti parametri di deep learning, mantieni semplicemente le impostazioni predefinite. Il sistema viene già fornito con valori predefiniti ottimali adattati agli scenari industriali.
| Parametro | Codice | Descrizione |
|---|---|---|
| Device | Device | Auto rileva automaticamente, 0 è la prima GPU, cpu forza l'uso della CPU. |
| Resume | Resume | Quando selezionato, l'ultimo last.pt interrotto viene localizzato automaticamente e il training riprende da esso. |
| Cache | Cache | Memorizza i dati nella cache in memoria o su disco per velocizzare il training. Si consiglia di disattivarlo quando la memoria è limitata. |
| Mosaic | Mosaic | Abilita la probabilità di augmentation mosaic multi-immagine (0.0 ~ 1.0). Migliora la percezione di piccoli oggetti. |
| Close Mosaic | Close Mosaic | Disattiva l'augmentation Mosaic per gli ultimi N epochs, impedendo al modello di oscillare verso la fine del training. |
| Initial learning rate | lr0 | Il learning rate iniziale, generalmente il valore predefinito 0.01; controlla la dimensione del passo degli aggiornamenti dei parametri. |
| AMP | AMP | Consigliato di abilitare. Risparmia memoria GPU e velocizza il training, con essenzialmente nessun impatto sull'accuratezza. |
| Period | Period | La frequenza con cui i pesi vengono salvati o la validazione viene eseguita, in epochs. -1 significa automatico. |
| Patience | Patience | Interrompe il training quando la metrica di validazione non mostra miglioramenti per N epochs consecutivi. 0 lo disabilita. |
| Optimizer | Optimizer | auto seleziona automaticamente; è anche possibile specificare manualmente SGD, AdamW, ecc. |
| Dropout | Dropout | Il rapporto di regolarizzazione (0.0 ~ 1.0), utilizzato per prevenire l'overfitting del modello. |
| Weight decay | Weight Decay | Il coefficiente di regolarizzazione L2, che impedisce a pesi del modello eccessivamente grandi di degradare la generalizzazione. |
| Mixup | Mixup | La probabilità di fondere due immagini e le loro label (0.0 ~ 1.0). Aumenta la diversità dei campioni. |
| Copy-Paste | Copy-Paste | Copia e incolla casualmente oggetti su altre immagini, migliorando il recall del modello. |
| Freeze | Freeze | Congela i pesi dei primi N layer del modello. Adatto per il fine-tuning di un modello pretrained. |
| Visualization tool | TB | Quando abilitato, log dettagliati (loss, metriche) vengono registrati con TensorBoard. |
TensorBoard
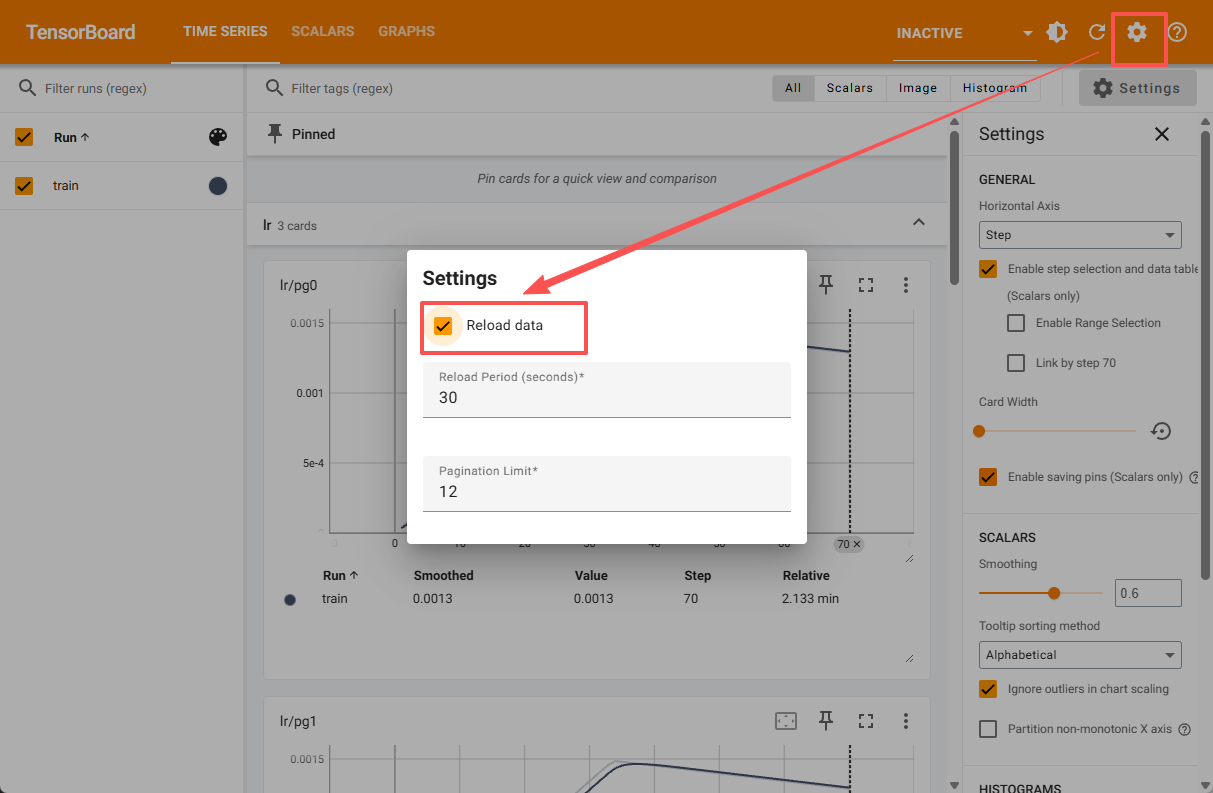
Dopo aver selezionato "relaod data", TensorBoard aggiorna automaticamente i dati, ogni 30 secondi per impostazione predefinita.
5. Flusso di Lavoro dell'Auto Labeling
- Carica il modello: seleziona il miglior file di pesi che è stato generato (
best.pt). - Imposta la soglia: regola Conf; si consiglia un valore tra
0.3 ~ 0.5a seconda della scena. - Esegui il labeling: il sistema scansiona automaticamente la directory delle immagini e genera le corrispondenti label JSON.
- Verifica e conferma: utilizza il modulo "Image Annotation" per eseguire una rapida revisione manuale.
6. Risultati Finali
Risultati Finali
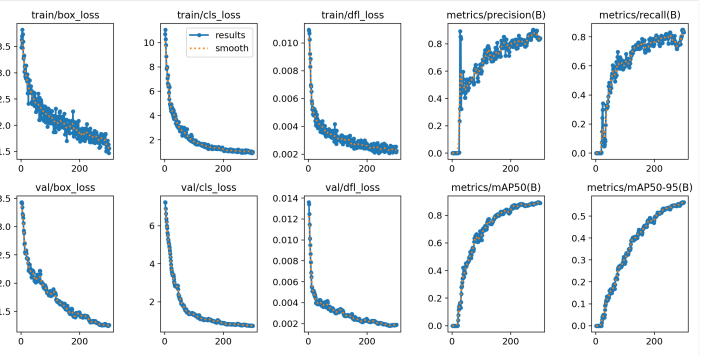
Al termine del training, i grafici di valutazione finali sopra sono forniti come riferimento.
Note sull'Ambiente
- Non chiudere la console del software durante il training, altrimenti il processo verrà interrotto forzatamente.
- Se utilizzi la modalità OBB rotated box, assicurati che il formato JSON del dataset sia definito correttamente (Length1/Length2 sono la semi-larghezza e la semi-altezza).