分類データセットの生成
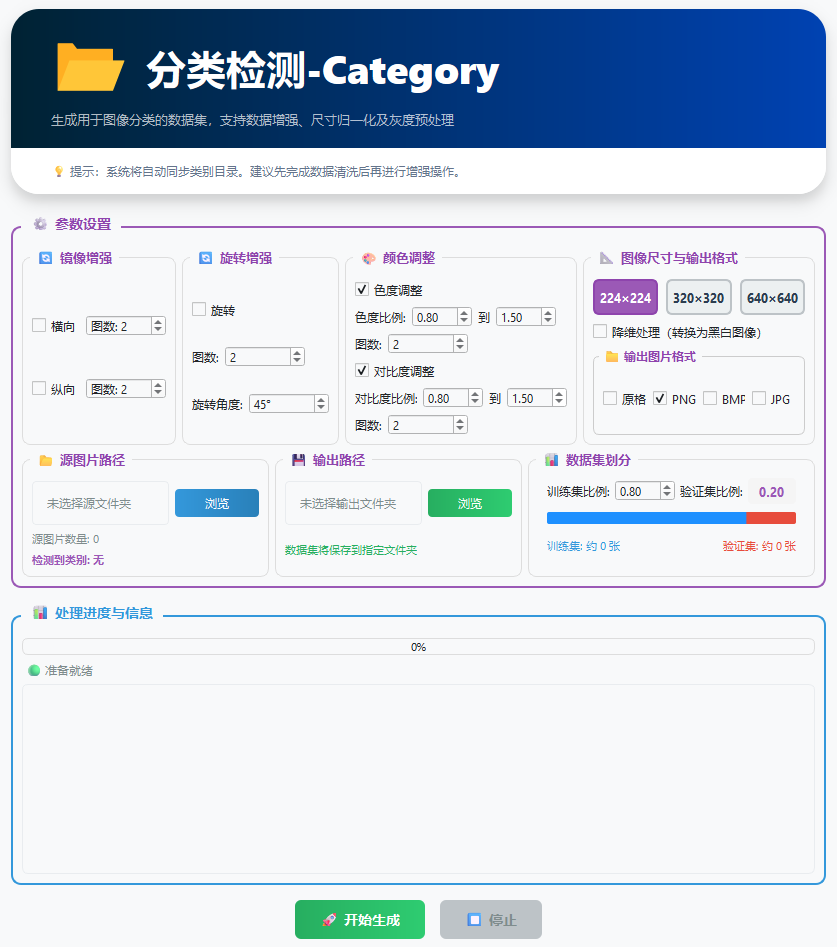
分類モデル用データセットを、データ拡張、形式変換、学習・検証分割と合わせて生成します。
1. 処理の流れ
- クラスごとに分けられたフォルダーから元画像を読み込みます。
- 反転・回転・色変換でサンプルを増やします。
- 指定した画像形式に変換します。
- 指定割合で
trainとvalに分けます。
2. データ拡張
| 方法 | 内容 | 用途 |
|---|---|---|
| 左右反転 | Y 軸対称 | 部品の左右差 |
| 上下反転 | X 軸対称 | 向きが一定でない搬送物 |
| 一周回転 | 360° のランダム回転 | 円形部品の向きへの対応 |
| 色度 / コントラスト | 色・明暗の変更 | 照明や露光の変動 |
必要な処理を選び、それぞれの「枚数」を指定します。
3. 出力形式と分割
- BMP / PNG: 可逆形式。高精度の欠陥分類向け。
- JPG: 圧縮により容量を削減。
- 元の形式: 元の拡張子を保持。
- 学習割合
80はtrainに 80%、valに 20%。100はすべて学習用で、検証データは分割しません。
4. 操作
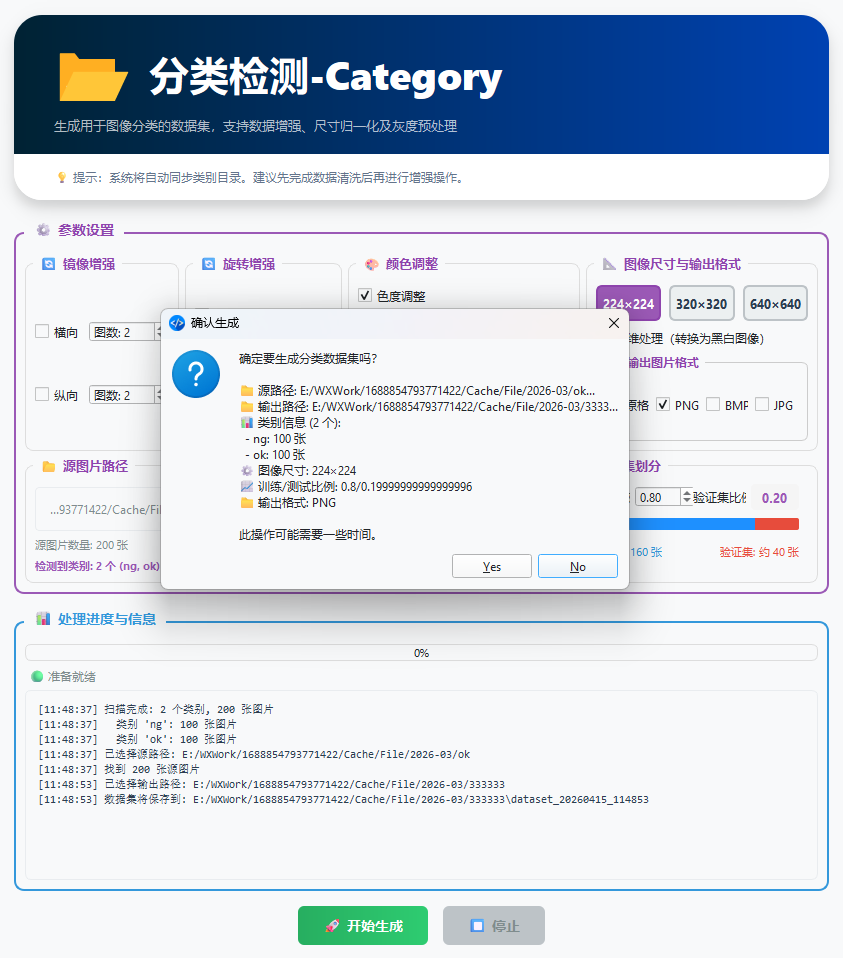
入力には OK/、NG/ などを含むルートを選び、出力には空のフォルダーを指定します。枚数、サイズ、形式、分割割合を確認して「生成開始」を実行します。
5. 出力構成
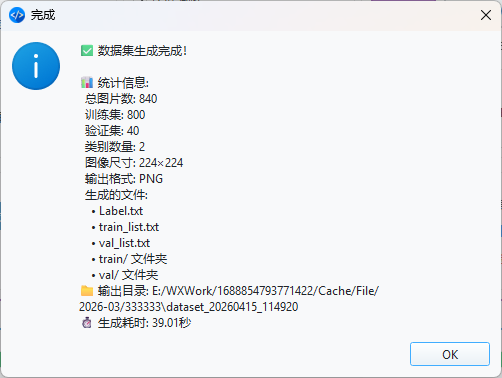
dataset_20260415_114920/
├── train/
│   ├── OK/
│   └── NG/
├── val/
│   ├── OK/
│   └── NG/
├── Label
├── train_list
└── val_list
クラス間のバランス
NG が 20 枚、OK が 200 枚の場合は、NG を約 200 枚まで増やすなど、クラス間の偏りに注意してください。