Generazione Dataset Classificazione e Rilevamento
Il Classification Tool è progettato per costruire i dataset di addestramento richiesti dai modelli di classificazione di deep learning. Supporta l'augmentation dei dati in tempo reale prima dell'esportazione, la transcodifica multi-formato e una flessibile suddivisione della mappa dei campioni, permettendoti di generare con un solo clic una struttura di directory che soddisfa i requisiti dei framework più diffusi.
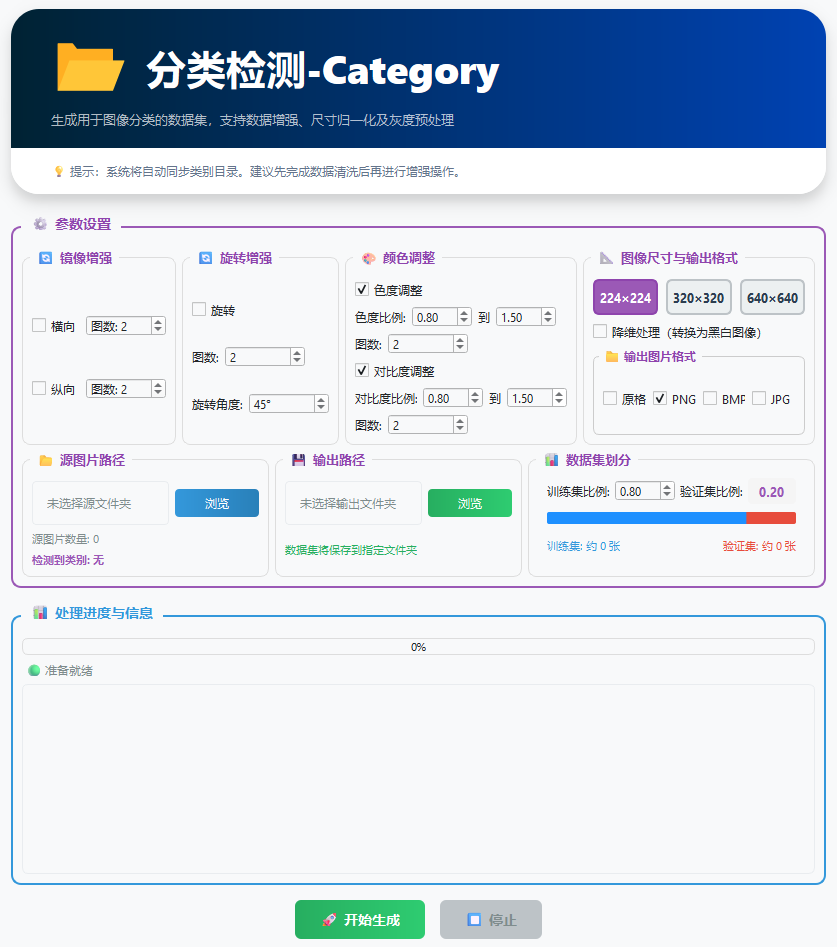 
1. Flusso di Lavoro Principale
Il classification tool esegue le sue operazioni nel seguente ordine logico:
- Lettura: scansiona le immagini originali nella directory di input, dove le immagini sono già raggruppate per classe tramite cartella.
- Augmentation: applica mirroring, rotazione o trasformazioni di colore ai campioni di ciascuna classe in base alla configurazione.
- Transcodifica: converte uniformemente tutti i campioni generati nel formato immagine specificato.
- Distribuzione: suddivide i dati nelle cartelle
train(training set) eval(validation set) in base al ratio configurato.
2. Configurazione dell'Aumento Dati
Prima della generazione, puoi selezionare i seguenti operatori di augmentation. A partire dalle immagini originali, il sistema le espande eseguendo trasformazioni fino al "Image Count" che hai impostato:
| Operatore di Augmentation | Logica Fisica | Raccomandazione per Applicazioni Industriali |
|---|---|---|
| Mirroring Orizzontale | Capovolgimento sinistra-destra (simmetrico rispetto all'asse Y). | Adatto per distinguere varianti sinistra/destra di un pezzo. |
| Mirroring Verticale | Capovolgimento alto-basso (simmetrico rispetto all'asse X). | Adatto per materiali su nastro trasportatore senza orientamento fisso. |
| Rotazione Completa | Rotazione di 360° a un angolo casuale. | Essenziale per pezzi rotondi; risolve il problema dell'invarianza alla rotazione per template con dot-mark. |
| Tonalità / Contrasto | Variazione casuale di luminosità e colore. | Simula le fluttuazioni di illuminazione e le differenze di esposizione della camera sul piano di produzione. |
3. Parametri di Generazione
Formato di Output delle Immagini
Puoi scegliere il formato di destinazione in base alle tue esigenze di archiviazione o ai requisiti del framework di addestramento a valle:
- BMP / PNG: formati lossless, consigliati per la classificazione di difetti industriali ad alta precisione.
- JPG: formato compresso, adatto per dataset di grandi dimensioni e consente di risparmiare spazio su disco.
- Formato originale: nessuna ricodifica; il suffisso originale dei file di input viene mantenuto invariato.
Ratio Training / Validation Set
- Come funziona: il valore del ratio rappresenta la percentuale di dati assegnata al training set.
- Esempio di suddivisione: se impostato a 80, l'80% dei dati va nella cartella
traine il 20% nella cartellaval. - Impostazione speciale: se impostato a 100, il sistema non esegue alcuna suddivisione e restituisce tutto come training set.
4. Passi
- Configura i percorsi:
- Directory di input: seleziona il percorso radice contenente le cartelle delle classi originali (come
OK/,NG/). - Directory di output: specifica dove verrà memorizzato il dataset generato (si consiglia una cartella nuova vuota).
- Directory di input: seleziona il percorso radice contenente le cartelle delle classi originali (come
- Imposta l'image count: inserisci il numero totale di immagini che desideri vengano infine generate per ciascuna classe.
- Esegui la generazione: dopo aver confermato il formato e il ratio, clicca su [Start Generation].
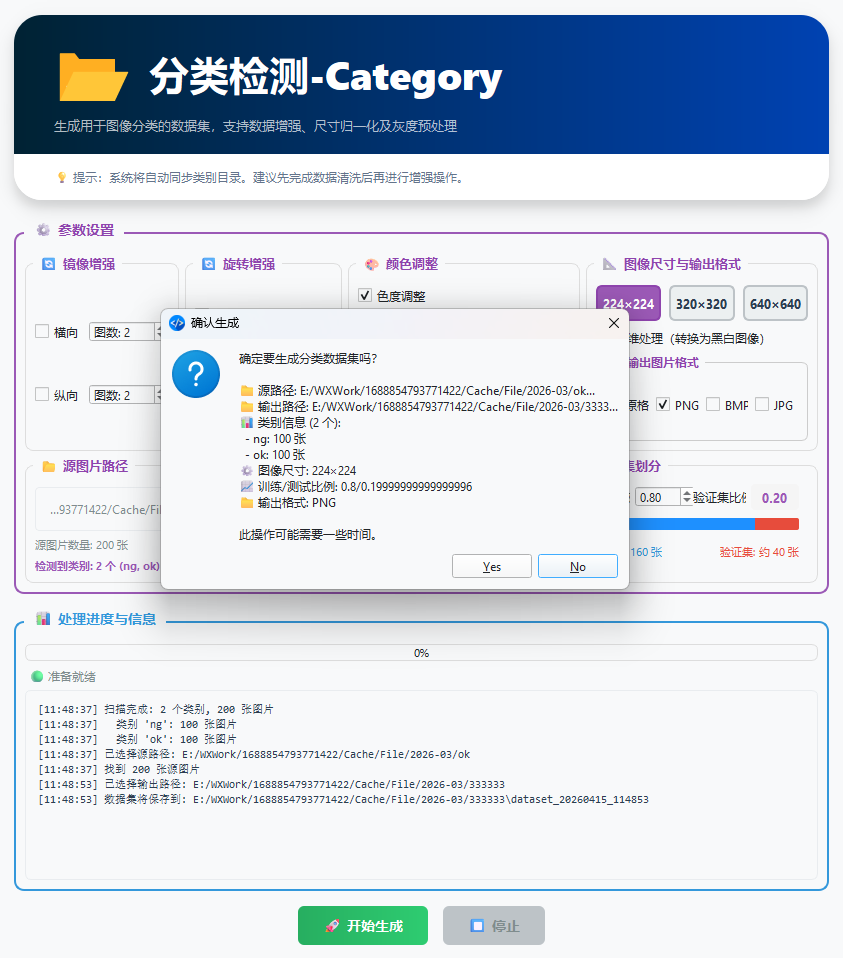
5. Anteprima della Struttura della Directory di Output
Al termine della generazione, la tua directory di output avrà la seguente struttura:
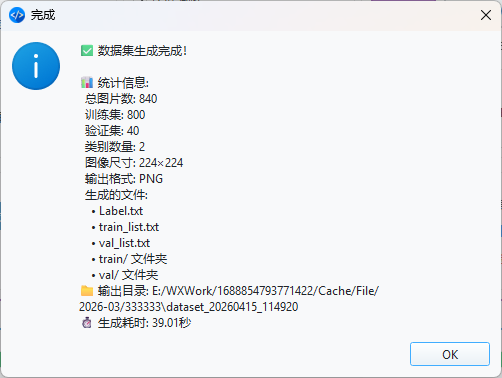
dataset_20260415_114920/

├── train/              # Percorso del training set (Train)

│   ├── OK/       # Campioni normali aumentati

│   └── NG/       # Campioni di difetto aumentati

└── val/                # Percorso del validation set (Val)

    ├── OK/       # Campioni di validazione suddivisi automaticamente

    └── NG/       # Campioni di validazione suddivisi automaticamente

├── Label         # Contiene le informazioni sulle classi

├── train_list    # Elenco immagini del training set

├── val_list      # Elenco immagini del validation set
Condivisione dalla Pratica di Sviluppo
Nei task di classificazione industriale, il bilanciamento dei campioni è fondamentale. Se hai solo 20 campioni NG originali ma 200 campioni OK, aumenta la classe NG fino a circa 200 immagini, il che previene efficacemente lo sviluppo di un bias di classe da parte del modello.